Over halvparten av trafikken på nettet kommer ikke lenger fra mennesker. I juni rapporterte Cloudflare at 57 prosent av forespørslene til et utvalg nettsteder i nettverket deres kom fra automatiserte roboter. Ifølge Cloudflares toppsjef er det særlig AI-agentene som driver veksten. Agentene leser, sammenligner og utfører i økende grad oppgaver på vegne av andre. Mange roboter driver riktignok fortsatt mest med ugagn.
Webløsninger
For et par år siden skrev vi at Google ofte omtales som nettets viktigste blinde besøkende. Nå har den besøkende fått selskap.
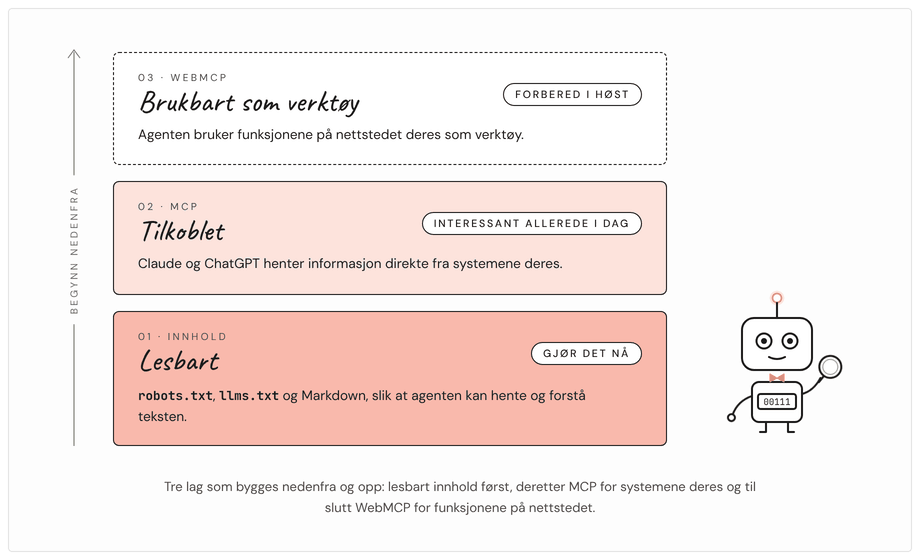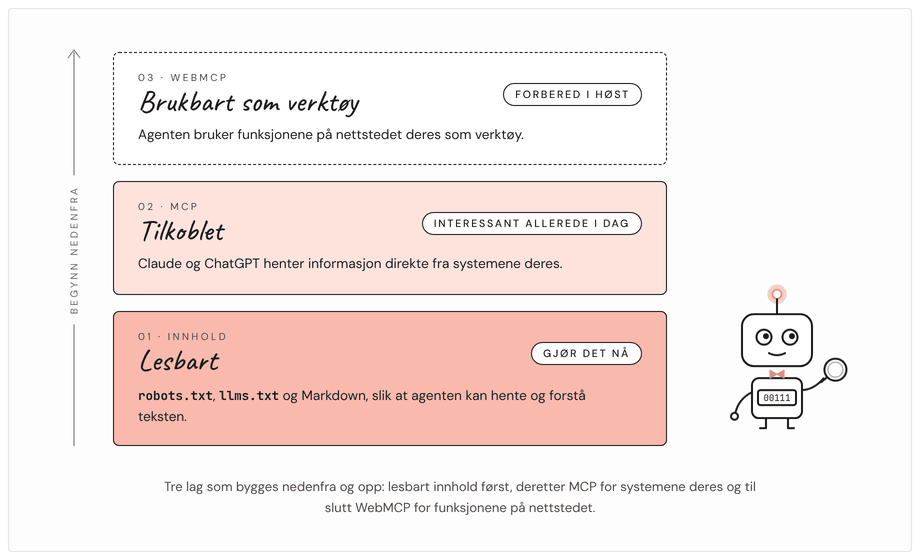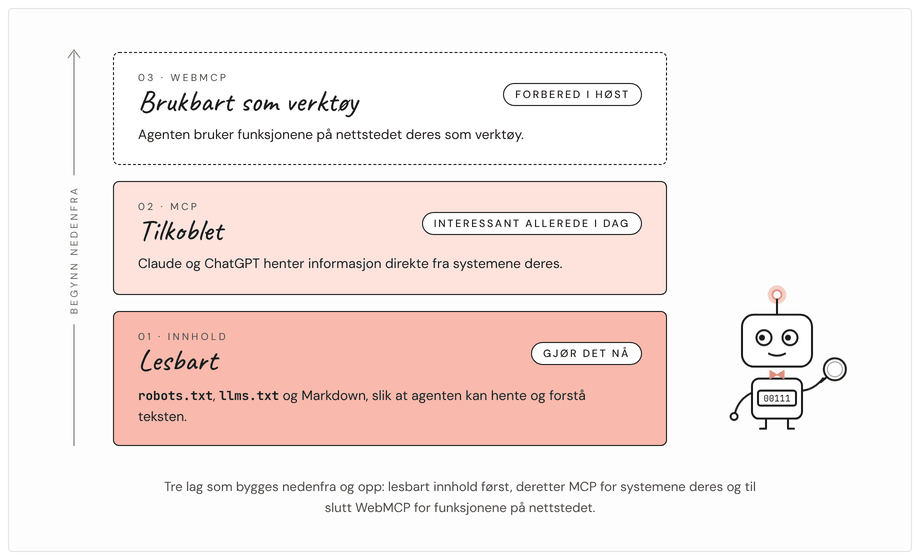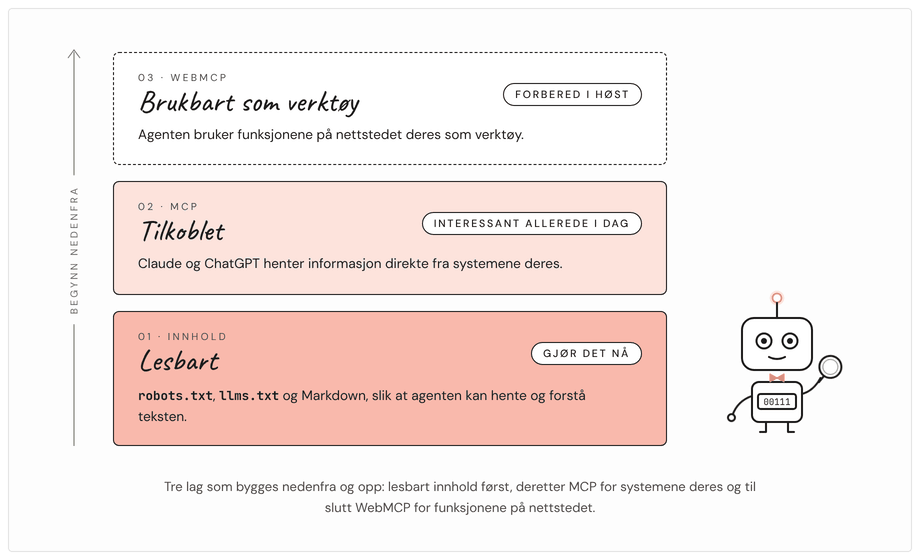
Tre lag: lese, spørre og handle
Lese. Agenten skal kunne hente og forstå innholdet deres.
Spørre. Systemene deres skal kunne svare på spørsmål fra Claude eller ChatGPT via MCP.
Handle. Agenten skal kunne bruke funksjonene på nettsiden via WebMCP.
Strukturert informasjon er ikke noe nytt
Rundt årtusenskiftet var argumentet søkemotorer. Rundt 2010 var det universell utforming. Nå er det agenter. Jobben er den samme: Merk opp innholdet slik at en maskin forstår hva som er overskrift, brødtekst og navigasjon. Det meste handler om å gjøre det vi allerede gjør, og godt strukturert HTML er fortsatt grunnmuren.
Tre ting rekker dere på en ettermiddag:
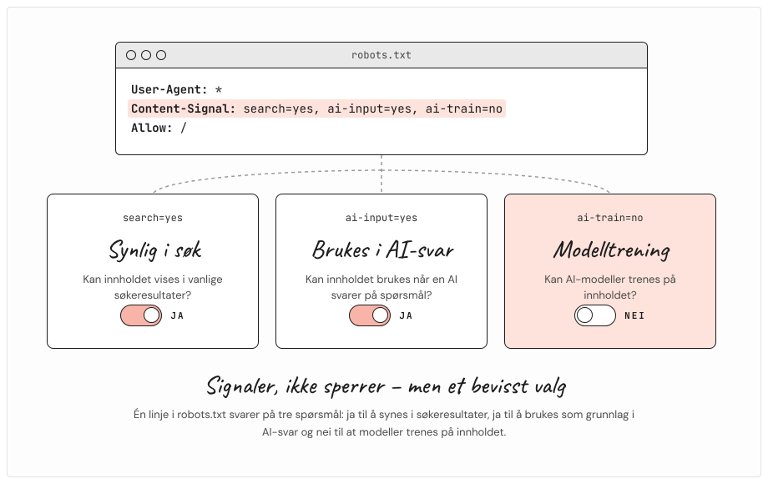
Sjekk robots.txt. Blokkerer dere GPTBot og ClaudeBot? Enkelte tjenester, blant annet Cloudflare, blokkerer AI-roboter som standard på nye domener. Det kan altså ha skjedd uten at noen har bestemt det. Med Content-Signal kan dere i tillegg ta stilling til tre spørsmål: Skal innholdet vises i søkeresultater? Skal det kunne brukes som grunnlag i AI-svar? Skal modeller få trenes på det? Dette er signaler, ikke sperrer. Ingen av de store AI-selskapene har så langt bekreftet at de følger dem, men poenget er å ta et bevisst valg.
Legg til en llms.txt. Dette er et forslag, ikke en standard, og det er uklart hvor mye filen faktisk brukes. Men den koster nesten ingenting å lage. Tanken er at den skal fungere som en kuratert innholdsfortegnelse for agenter.
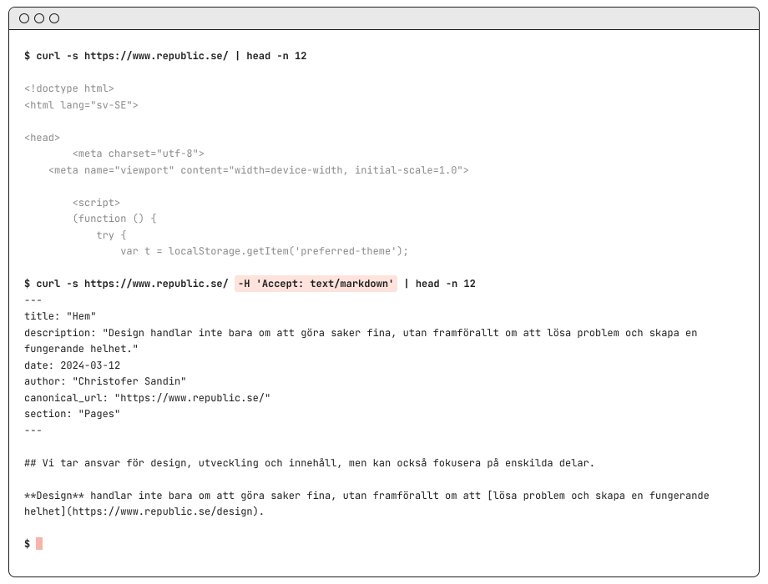
Tilby Markdown. Enten samme URL med .md på slutten, eller samme URL der klienten ber om Accept: text/markdown. Da får agenten ren tekst i stedet for HTML.
robots.txt
Det finnes mange innstillinger i robots.txt. Slik ser den vi snakker om ut:
93 prosent mindre å lese
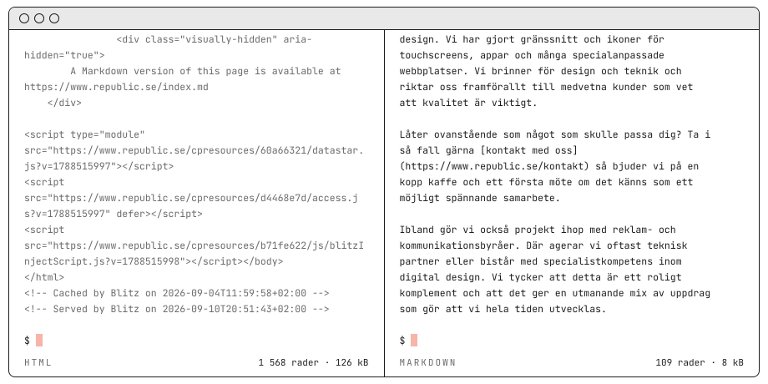
Vi har testet. Da vi målte, var forsiden på www.republic.se 127 129 byte som HTML og 8 445 byte som Markdown. Det er rundt 93 prosent mindre. HTML-versjonen består hovedsakelig av div-tagger, skript og CSS-klasser. Et sted der inne ligger teksten.
Gevinsten ligger ikke i båndbredden. Agentene er flinke til å tolke HTML, og 93 prosent færre byte betyr ikke 93 prosent lavere kostnad. Gevinsten ligger i kontekstvinduet. Hver gang du stiller agenten et spørsmål, sendes hele samtalen så langt med. Jo mindre støy som følger med, desto mer kapasitet er igjen til selve oppgaven.
Resultatet er raskere svar og tydeligere resonnementer. Det reduserer også risikoen for hallusinasjoner, som øker når informasjonen ikke får plass i kontekstvinduet. Det gjelder særlig enklere modeller med mindre vinduer.
Er det ikke cloaking å vise agenter noe annet? Nei. Cloaking betyr at roboter får annet innhold enn mennesker. Her er innholdet det samme, og det er klienten selv som ber om formatet. API-er har brukt den samme mekanismen i snart 30 år.
Foreløpig er det først og fremst kodeverktøy som ber om Markdown: Claude Code, Cursor og GitHub Copilot. Også Microsofts Copilot-chat gjør det. Chattetjenester som ChatGPT, Claude.ai, Gemini og Perplexity henter fortsatt HTML, ifølge acceptmarkdown.com. Er målgruppen deres utviklere som spør kodeagenten sin om dokumentasjonen deres, lønner det seg allerede i dag. For alle andre er kostnaden så lav at det uansett er verdt det.
Hvordan tilbyr vi Markdown i praksis?
Det finnes to tekniske løsninger, og de utfyller hverandre. Vi kan tilby en egen adresse med .md på slutten. Vi kan også la klienten be om Markdown på den vanlige adressen ved å sende Accept: text/markdown i forespørselen.
Den andre løsningen bygger på HTTPs innebygde mulighet til å forhandle om format, såkalt content negotiation. Serveren må da sende Vary: Accept i svarets header, slik at hurtigbuffere vet at svaret kan variere. Innholdet skal være likeverdig i begge versjonene. HTTP Semantics beskriver hvordan dette fungerer.
I Republic har vi utviklet plugins for Craft CMS og Statamic som genererer Markdown fra innholdet på nettsiden. Craft-versjonen kjører på republic.se, og det var den vi viste på seminaret.
Dette gjør ikke løsningen mer kompleks. Redaktøren oppdaterer innholdet ett sted, og systemet leverer det i formatet som etterspørres.
Det som ikke fungerer
Her er det lett å gå i fella. Evil Martians gikk gjennom over tretti blogginnlegg, kodelagre og spesifikasjonsforslag og vurderte teknikkene de fant. Åtte av dem hadde ingen effekt, blant annet disse:
Oppdiktede metatagger som ai-content-url og llms, og filer som /ai.txt.
HTML-kommentarer. De fjernes før modellen ser teksten.
«AI-versjon»-knapper. Agenter klikker ikke på knapper.
User-Agent-sniffing. Google regner det som cloaking å vise roboter en egen versjon. Bruk content negotiation i stedet.
Viktig informasjon bare i JSON-LD. I en test fra SearchVIU gikk ChatGPT, Claude, Perplexity, Gemini og Copilot glipp av produktdata som kun lå der.
Behold likevel de strukturerte dataene. Google anbefaler dem fortsatt. Bare ikke legg viktig informasjon kun der.
Hvorfor anbefaler så mange disse teknikkene? Sannsynligvis fordi noen finner på en fil eller en metatagg og skriver et blogginnlegg om det. Andre siterer innlegget, og så er det i gang. Problemet er at ingen sjekker om noe AI-system faktisk har nytte av rådet.
Det kjedeligste rådet er det beste: skriv bedre tekst
Tar du bare med deg én ting fra denne artikkelen, la det være dette. En forskergruppe fra Princeton og IIT Delhi testet ni strategier for å bli synlig i AI-genererte svar. Det som virket, var å styrke den synlige teksten. Kildehenvisninger økte synligheten med opptil 115 prosent for sider lenger ned i resultatlisten. Siden øverst tapte derimot rundt 30 prosent. Direkte sitater ga en økning på rundt 40 prosent, og statistikk rundt 30 prosent.
Det beste rådet for AI-optimalisering er bransjens kjedeligste råd: skriv bedre tekst.
Vær konkret, oppgi kilder og bruk tall. Det er også det eneste rådet som holder uansett hvilken standard som vinner.
Neste del handler om informasjon og funksjoner som finnes i systemene deres, men som kanskje krever at noen logger inn og leter dem fram manuelt.
MCP kobler AI-verktøy til systemene deres
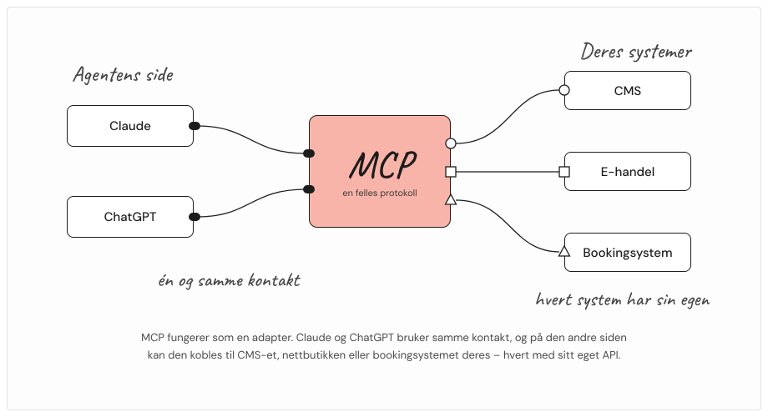
Et API kan sammenlignes med en stikkontakt, og hver applikasjon har valgt sin egen type. Model Context Protocol (MCP) er adapteret. Det gir agenten én kontakt som kan kobles til hva som helst på den andre siden, enten det er publiseringsløsningen, nettbutikken eller bookingsystemet. Protokollen ble utviklet av Anthropic og forvaltes i dag av Linux Foundation, med støtte fra blant andre OpenAI, Google og Microsoft. I praksis har den blitt dagens standard.
Tenk deg at dere arrangerer et seminar og vil vite hvilke deltakere som har oppgitt allergier. Eller at dere hver uke må sammenstille informasjon om alle nye ordrer. Med riktig kobling kan en agent hente dette gjennom et avgrenset verktøy, med akkurat de tilgangene dere har gitt den.
For mange av kundene våre er interne arbeidsflyter et naturlig sted å starte med MCP. Protokollen kan selvsagt også brukes i tjenester med eksterne brukere. Jeg bruker for eksempel MCP til å hente e-post fra e-postklienten vår. Det avgjørende er hvilke data og funksjoner dere velger å åpne for, og hvem som skal få bruke dem.
Utgangspunktet bør være arbeidet som faktisk skal bli enklere. Hvilke oppgaver gjentas ofte? Hvilken informasjon tar lang tid å finne fram? Med en tydelig oppgave er det lettere å vurdere om integrasjonen er verdt å bygge.
WebMCP beskriver hva nettsiden kan gjøre
Så har vi brukeren som vil få noe gjort på selve nettsiden. Hun vil sammenligne produkter, fylle ut et skjema eller bestille time.
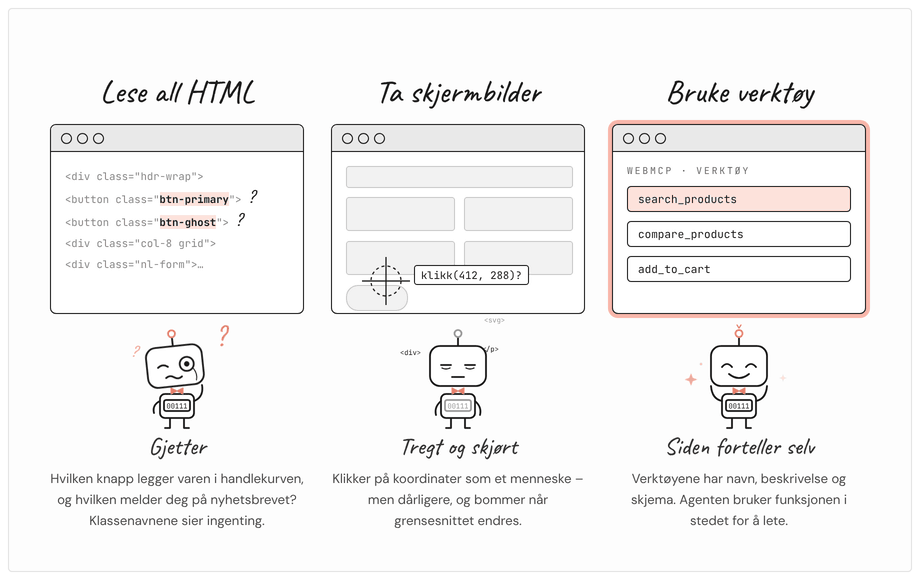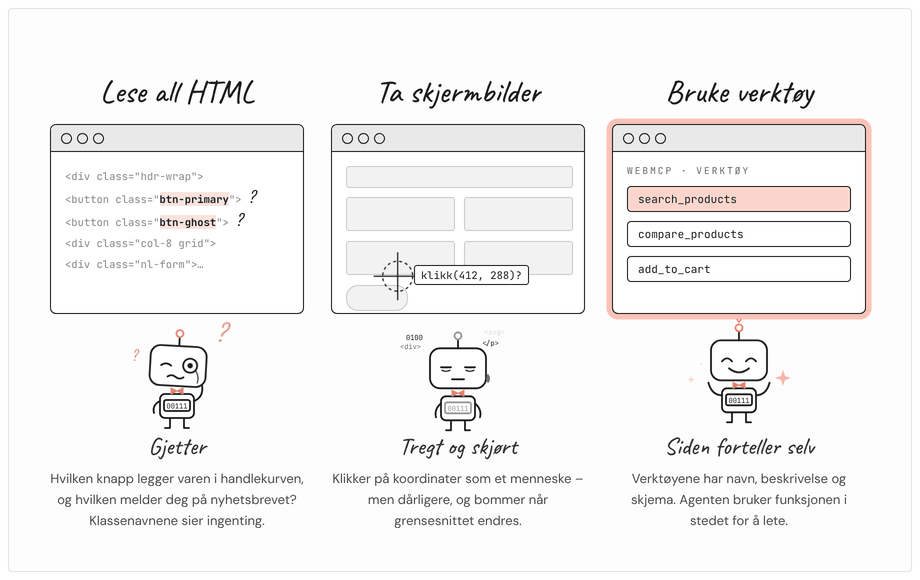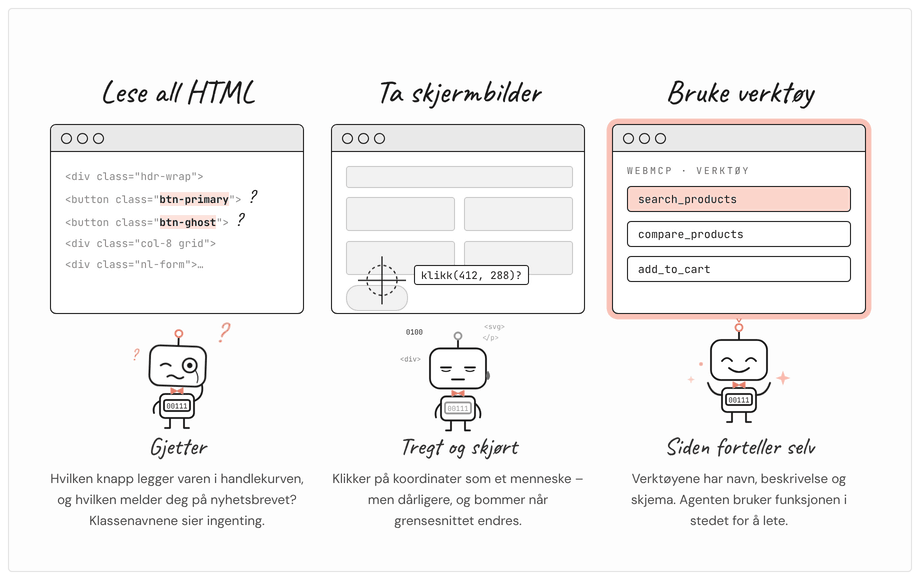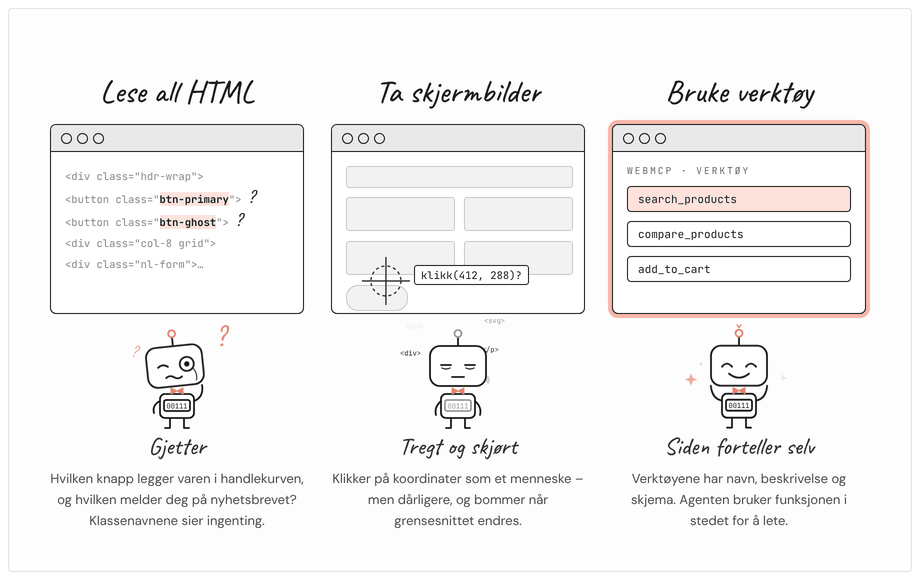
En agent kan forsøke å gjøre dette ved å tolke sidestrukturen, eller ved å ta skjermbilder og klikke seg fram. Det fungerer ofte, men blir lett ustabilt når grensesnittet endres eller neste steg er uklart. Framfor alt tar det tid. Agenten gjør den samme jobben som et menneske, bare dårligere og tregere.
Med WebMCP kan funksjoner beskrives som verktøy direkte i nettsiden. Hvert verktøy har et navn, en beskrivelse og et skjema som angir hvilke opplysninger det tar imot. En agent som støtter dette, kan ta i bruk funksjonen via nettleseren. WebMCP-forslaget beskriver hvordan det er tenkt å fungere.
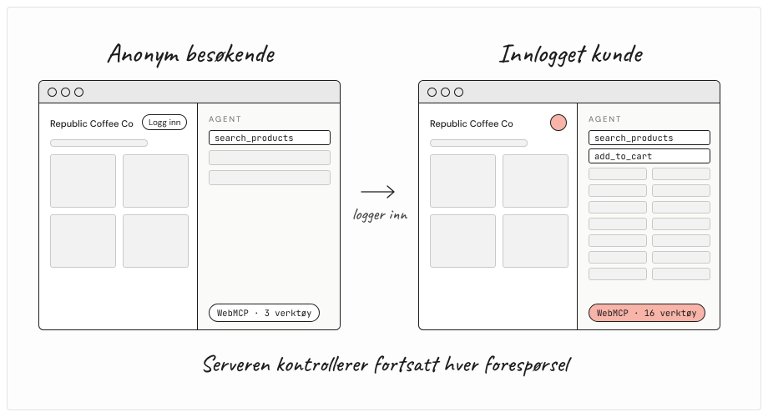
Republic, som er en del av 99x har en demobutikk som heter Republic Coffee Co. Der kan en agent bruke butikkens søkefunksjon til å hente informasjon om produkter. Ett av verktøyene heter search_products og bruker den samme søkefunksjonen som butikken allerede har.
Det blir ganske håndfast når man ser det i praksis. Kunden spør om et bestemt produkt, og agenten henter opplysningene direkte uten å måtte lete. Deretter kan kunden be om en sammenligning og få hjelp til å legge produktet i handlekurven.
Verktøyene kan tilpasses situasjonen. Serveren må likevel kontrollere at brukeren har lov til å utføre hver enkelt handling, akkurat som med en menneskelig besøkende.
På sikt er dette den mest spennende delen. Funksjoner vi allerede har bygget, kan bli enklere å bruke for den som får hjelp av en agent. En produktfiltrering kan for eksempel få en ny inngang der kunden beskriver behovet sitt med egne ord.
Brukeren må forstå og kunne styre det som skjer
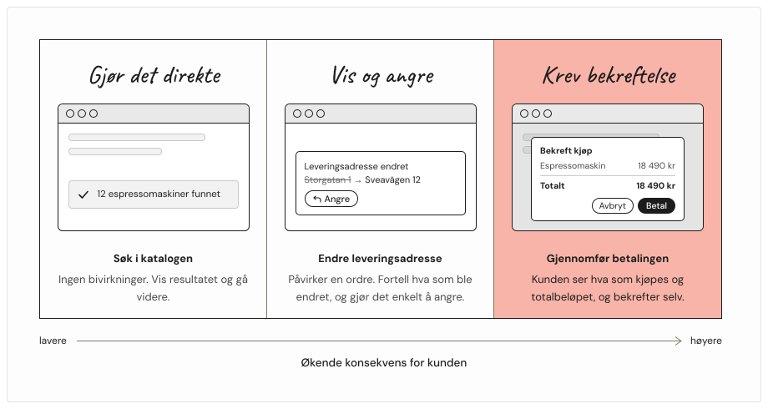
Når en agent handler på vegne av brukeren, blir tilbakemeldingene viktige. Det må være tydelig hva som har skjedd, og om brukeren må ta stilling til noe.
Et søk, en endret leveringsadresse og en betaling har ulike konsekvenser. Derfor bør en tilpasse kontrollpunktene til handlingen. Et søk i produktkatalogen kan skje umiddelbart. Før en betaling gjennomføres, må kunden derimot se hva som kjøpes og hva det koster totalt, og selv bekrefte kjøpet. Først da har kunden grunn til å stole på systemet.
Inndata må fortsatt valideres og tilganger kontrolleres på serveren, akkurat som ved alle andre forespørsler. Tydelige verktøy gjør det lettere å beskrive hensikten, men de erstatter ingen av disse kontrollene.
Dette henger sammen med UX-design for AI. Brukeren må få nok innsyn til å vurdere hva systemet gjør, og kunne gripe inn ved behov. Når en agent hjelper til i en nettbutikk, er det fortsatt kundens penger og kundens beslutning. Alt som gjøres, skjer i kundens navn og med kundens fullmakter.
Et fornuftig første prosjekt
WebMCP er fortsatt et utkast fra W3Cs Web Machine Learning Community Group. Det er ennå ikke en W3C-standard, og støtten varierer mellom nettlesere og agenter. En bør starte med en avgrenset pilot og testet én konkret oppgave.
Søk og produktsammenligning er gode kandidater. Ifølge HUMAN Securitys målinger for april 2026 gikk rundt 69,6 prosent av agenttrafikken til produkt- og søkesider, mens bare rundt 3,2 prosent gikk til kasse og betaling. Tallene gjelder trafikken på deres plattform og viser besøk på ulike typer sider, ikke gjennomførte kjøp. Likevel gir de en god pekepinn på hvor vi står i dag. Rapporten fra HUMAN Security gir flere detaljer om målingen.
Det er mer å hente på å gjøre produktinformasjonen lett tilgjengelig enn på en helautomatisert kasse. En kan teste om agenten finner riktig produkt, og om svarene hjelper kunden å velge. Deretter tar vi neste steg basert på det vi lærer.
Hva lønner det seg å gjøre nå?
For en vanlig innholdsside ville jeg startet med å sjekke tilgangen og gå gjennom tekststrukturen. Finnes informasjonen kundene spør etter? Kan den finnes og leses også utenfor det visuelle grensesnittet? Deretter er Markdown et fornuftig tillegg, så lenge det kan genereres og vedlikeholdes fra samme kilde.
Har dere gjentakende oppgaver i interne systemer, kan en MCP-kobling være verdt å se nærmere på. For en nettbutikk eller portal med tydelige brukeroppgaver kan en liten WebMCP-pilot gi nyttig erfaring med hvordan mennesker og agenter bruker funksjonene sammen. Er de ansatte allerede vant til å bruke Claude, ChatGPT eller Gemini på en fornuftig måte, og ville de hatt nytte av å hente informasjon fra nettsiden også? Da skal det ikke mye til for å prøve.
Delene kan utvikles hver for seg. Det viktigste er å velge et behov som kan beskrives tydelig og følges opp.
Republic startet med sin egen nettside og deres egne tester for å se hva som faktisk fungerer. Det gir et bedre grunnlag når de diskuterer neste steg med kundene sine.
Vil dere finne ut hva som gir mening for nettsiden eller systemene deres? Da tar vi gjerne en prat. Vi kan starte med et spørsmål kundene deres allerede stiller, eller en oppgave kollegaene deres gjør hver uke. Det er som regel et godt utgangspunkt.
Oppsummert
Lagene må plasseres i riktig rekkefølge. Det har ingen hensikt å bygge WebMCP-verktøy på en nettside som blokkerer robotene i robots.txt.
Lese: gjør det nå. Robots.txt, llms.txt og Markdown koster lite og fungerer uansett hvordan utviklingen går videre.
Spørre: kan være aktuelt allerede i dag. En MCP-server over funksjonene deres kan brukes i Claude allerede nå, og i ChatGPT avhengig av abonnement.
Handle: forbered dere i løpet av høsten. WebMCP er ikke en etablert standard ennå, men alt tyder på at det er den som gjelder i tiden framover.
Den blinde besøkende har altså fått selskap, og den nye gjesten vil gjøre mer enn å lese. Grunnlaget er likevel det samme som før: tydelig struktur og god tekst. Vil dere teste nettsiden deres, kan dere kjøre isitagentready.com og acceptmarkdown.com.
Vi har plugins for Craft CMS og Statamic som leverer Markdown og llms.txt rett fra publiseringsløsningen. På republic.se brukes de allerede. Vil dere vite hvor nettsiden deres står i dag, eller hvilke MCP- og WebMCP-verktøy som er verdt å bygge, tar vi gjerne et møte.